Sin cola hasta que haga falta: una plataforma de visión con YOLO que creció por evidencia
Una plataforma interna para entrenar e inferir con YOLO empezó con una decisión incómoda: la web esperaba con la conexión abierta mientras la GPU trabajaba, sin cola de tareas. Este artículo cuenta por qué, cómo cada límite se escribió junto con la señal que lo volvería inaceptable, y qué se construyó —y qué no— cuando esas señales llegaron.
Proyecto relacionado: YOLO Training & Inference Orchestration Architecture

Este artículo se basa en el case study de la arquitectura, una publicación solo documental, generalizada y anonimizada, de una plataforma interna de visión por computador. No nombra organización, campo de aplicación, sitio, hardware ni resultados medidos, y no incluye código.
La plataforma alrededor del modelo
En un artículo anterior conté cómo se evalúa si YOLO, con inferencia por recortes (SAHI), detecta objetos pequeños en imágenes de dron 4K. Esa es la parte que suele contarse. La otra es la plataforma que la rodea: cómo un grupo reducido de operadores e investigadores pide un entrenamiento o procesa un lote de imágenes sin entrar a una máquina con GPU, y cómo después se sabe qué modelo produjo qué resultado.
Dos procesos y una frontera
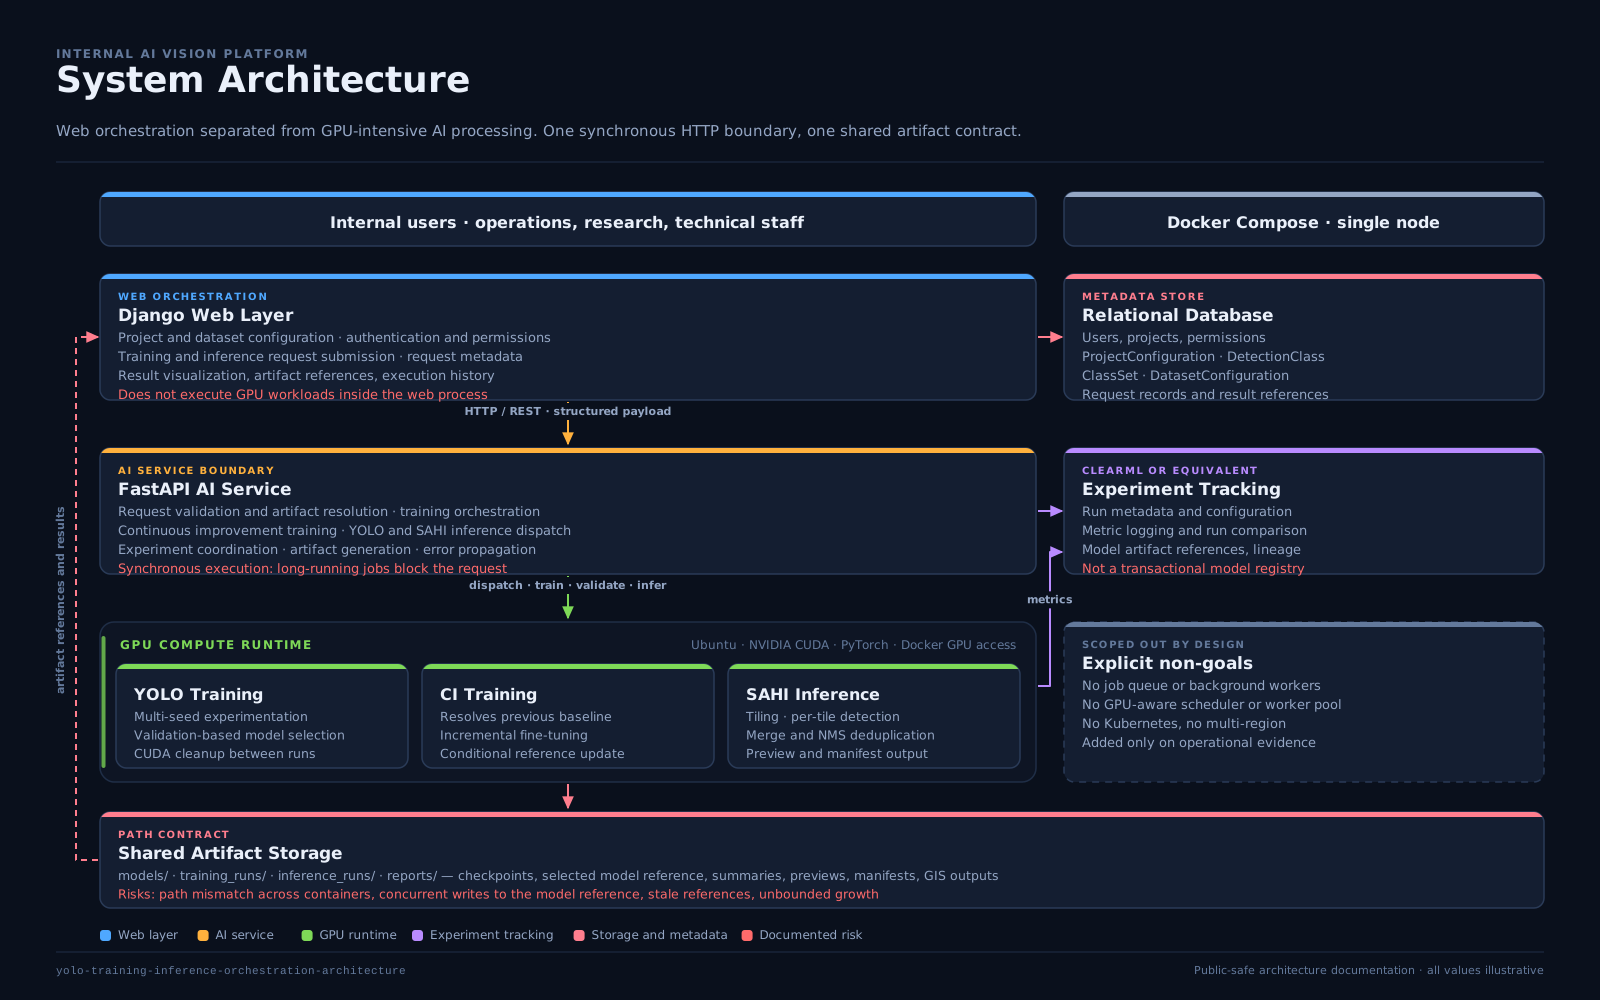
La primera decisión fue separar. Una capa web en Django atiende a las personas: formularios, validación, administración, resultados. Un servicio en FastAPI, aparte, es el único que toca la GPU: entrena, valida e infiere. Se hablan por HTTP con JSON, comparten un almacenamiento donde quedan los artefactos —modelos, manifiestos, salidas— y la base de datos es solo de la capa web; el servicio de IA no tiene base propia.
La razón no es estética. Un entrenamiento puede ocupar la GPU y la memoria durante horas, y no tiene nada que hacer dentro del proceso que responde a un navegador. Además, los dos lados piden entornos distintos: el entrenamiento con varias GPU es muy sensible a la combinación de sistema operativo, controladores y versión de CUDA, y por eso ese servicio se fijó en Ubuntu, mientras la web puede vivir donde convenga.
La decisión incómoda
En la primera versión no había cola de tareas. Cuando alguien pedía un entrenamiento, Django llamaba al servicio de IA y esperaba, con la conexión abierta, hasta que terminaba. No había Celery, ni Redis, ni un broker de mensajes.
Dicho así suena a descuido, y el case study no lo esconde. Con la petición abierta durante horas, el servicio de IA se vuelve un cuello de botella, un corte de red pierde el trabajo y, si el servicio se reinicia, no queda registro de lo que estaba en curso. Lo eligió igual, por razones concretas: era lo más simple de construir, lo más fácil de depurar —una petición, una respuesta, un error visible— y permitía validar la plataforma antes de invertir en infraestructura que quizás no haría falta.
Escribir el límite junto con su señal
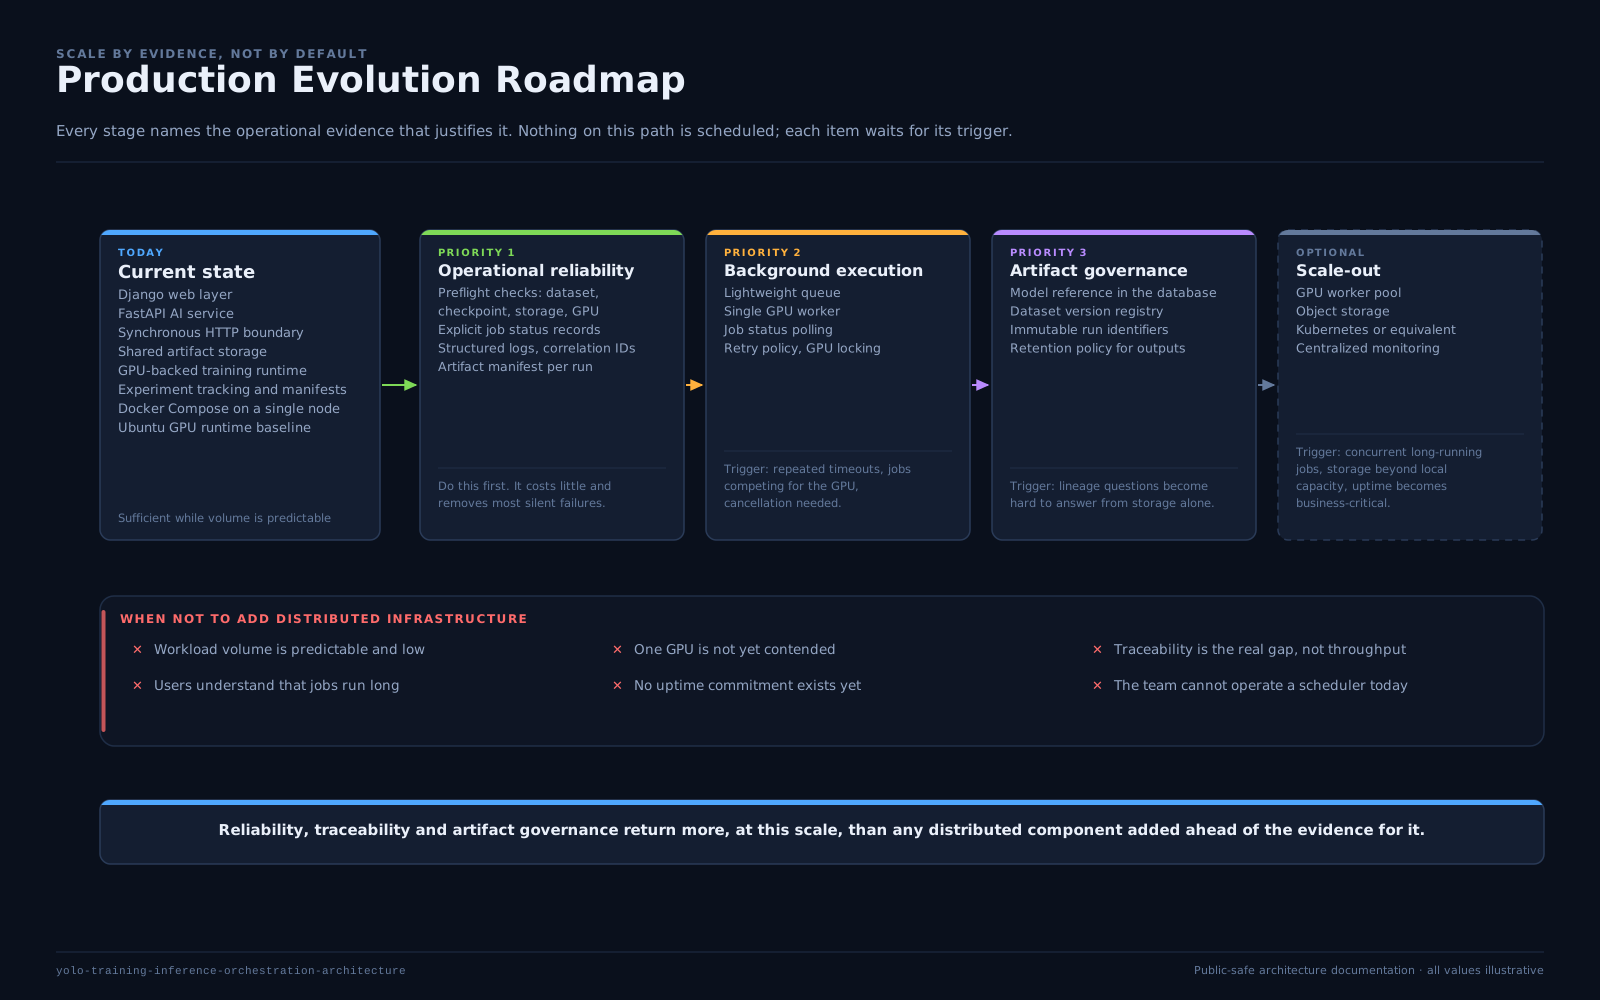
Lo que convierte esa decisión en ingeniería y no en deuda es cómo quedó escrita. Cada limitación se documentó junto con la señal que la volvería inaceptable: peticiones que vencen por tiempo, operadores que necesitan ver el avance, fallas que después no se pueden explicar. Y la hoja de ruta ordenó las respuestas: primero registros de estado y consulta periódica; un worker controlado solo cuando los trabajos compitan por la GPU; un broker solo cuando hagan falta reintentos, cancelación o varios workers.
Cuando llegaron las señales
Llegaron. Un lote de cientos de imágenes de alta resolución superaba cualquier tiempo de espera razonable. Los operadores preguntaban si el trabajo seguía corriendo, y la única forma de saberlo era mirar la GPU. Y un reinicio dejaba salidas a medio escribir, sin registro de qué estaba en curso.
La revisión aplicó el primer paso de la hoja de ruta y se detuvo ahí. Pedir un trabajo ahora devuelve de inmediato un identificador, y el trabajo corre en un grupo de hilos dentro del mismo servicio. Cada ejecución deja un registro durable, escrito de forma atómica, que la consola consulta cada pocos segundos. Al arrancar, el servicio reconcilia lo que quedó a medias. Sigue sin haber broker: no hacía falta todavía.
Las demás respuestas siguieron el mismo patrón, cada una a un límite que estaba escrito:
- un registro transaccional de modelos, con promoción explícita por una persona, en vez de una referencia en un archivo;
- una sola ruta de montaje en los dos contenedores, verificada por test, en vez de traducir rutas entre cuatro sistemas;
- una clave entre servicios, para que nadie más pudiera pedir trabajo de GPU;
- una batería de tests que corre sin GPU en integración continua.
Lo que quedó abierto
No todo se resolvió. La herramienta de seguimiento de experimentos se eligió al principio por la comodidad de su versión en la nube, y eso significaba que los datos salían de la organización por defecto. Se retiró, se decidió una alternativa autoalojada, y esa alternativa sigue sin desplegarse. El case study lo deja escrito igual que todo lo demás.
Tres lecciones
- Separar la GPU de la web desde el primer día. Es la decisión más barata de tomar al principio y la más cara de deshacer después.
- Un límite sin su señal es deuda; con su señal, es un plan. Escribir cuándo una decisión deja de servir es lo que permite tomarla sin culpa.
- Construir el primer paso, no la escalera. La revisión necesitó registros de estado y consulta periódica, no una cola distribuida, y supo detenerse ahí.
Diseñé y documenté esta arquitectura. Las decisiones (ADR), los límites, la hoja de ruta y la revisión posterior están en el repositorio del case study.
Comentarios
Los comentarios viven en GitHub Discussions: inicia sesión con GitHub en el cuadro de abajo para responder, o abre el hilo en GitHub.
¿Sin cuenta de GitHub? Deja tu comentario aquí
Los comentarios se revisan antes de publicarse. Tu correo es opcional y nunca se publica.